
핫 패스 규칙을 고칠지 규칙 성능 상세로 가늠하기
같은 그룹의 다른 규칙보다 느리고 그룹 전체 시간에서도 몫이 클 때만 핫 패스 규칙을 고칩니다.
문제
요청마다 고객사가 월 호출 한도 안에 있는지 확인하는 API 쿼터 검사가, 요금제별 한도 비교 세 개로 시작해 규칙 여섯 개로 늘어나는 동안 p99 지연 시간도 함께 늘었습니다. 규칙 하나를 다시 짜서 얻는 것이 있으려면, 그 규칙이 같은 그룹의 다른 규칙들보다 평가 시간이 눈에 띄게 길고 그룹 전체 시간에서도 큰 몫을 차지해야 합니다.
처음에는 요금제 셋(free · growth · pro)의 한도를 넘었는지 비교하는 것이 전부였습니다. 그 뒤로 모르는 요금제를 막는 규칙, 한도에 다가선 고객사를 표시하는 규칙, 고객군 라우팅 규칙이 붙어 여섯이 됐습니다. p99를 끌어올린 규칙이 있는지, 있다면 어느 것인지는 아직 모릅니다.
쿼터 검사는 요청마다 제일 먼저 실행되기 때문에, 여기서 쓴 시간은 모든 응답의 지연 시간에 그대로 반영됩니다. 규칙을 규칙 엔진에서 돌리면 APM 스팬은 policy evaluation에 걸린 시간을 숫자 하나로만 보여 줍니다. 규칙이 정책 버전 안에 데이터로 들어 있어서 스택 프레임에 규칙 이름이 찍히지 않습니다. CPU 프로파일러도 평가기 코드를 표본으로 잡을 뿐, 어느 규칙에 시간이 얼마나 걸렸는지는 남기지 않습니다. 평균 시간으로도 알 수 없습니다. 태그 목록이 긴 몇몇 요청에서만 느린 규칙은, 나머지 요청이 빨라서 평균에 묻힙니다.
이 글의 라우팅 규칙은 다른 규칙 대부분보다 두 배 넘게 느리지만, 쿼터 검사가 요청 하나에 보통 쓰는 0.8ms 가운데 이 규칙이 쓰는 시간은 약 0.026ms(3%)뿐입니다. 이 규칙을 아무리 빠르게 고쳐도 쿼터 검사는 3% 넘게 빨라질 수 없습니다.
남는 질문은 여섯 규칙 가운데 다시 짤 만한 것이 하나라도 있느냐입니다.
단순한 접근
보통 처음에는 규칙을 코드에 그대로 두고, 시간도 검사 전체를 한 번에 잽니다.
public class QuotaGate {

    private static final Map<String, Long> QUOTAS =
            Map.of("free", 10_000L, "growth", 100_000L, "pro", 1_000_000L);

    public Decision check(Request req) {
        long t0 = System.nanoTime();
        Decision d = evaluate(req);
        long elapsed = System.nanoTime() - t0;

        // 검사 전체를 하나의 숫자로 남깁니다.
        // 어느 분기가 그 시간을 썼는지는 남지 않습니다.
        log.info("quota_gate_ns={}", elapsed);
        return d;
    }

    private Decision evaluate(Request req) {
        Long quota = QUOTAS.get(req.plan());
        if (quota == null) {
            return Decision.deny("plan outside known plans");
        }
        if (req.callsThisMonth() > quota) {
            return Decision.deny("monthly quota exceeded");
        }
        // 새 기능을 일부에게만 열어 주려고 나중에 붙었습니다.
        // 요청마다 태그 목록을 훑습니다.
        if (matchesAnySegment(req.tags())) {
            return Decision.allowWithRoute(routeFor(req.tags()));
        }
        return Decision.allow();
    }
}
요금제 한도만 비교할 때는 타이머 하나로 충분하지만, 고객군 분기가 붙으면 같은 숫자 안에 값싼 조회와 태그 훑기가 섞입니다.
quota_gate_ns는 모든 분기의 지연 시간을 합친 것이라서, 나누려면 if마다 타이머를 두르고 분기가 바뀔 때마다 타이머도 손으로 맞춰야 합니다. 분기 순서를 바꾸다 타이머 하나를 빠뜨리면 측정은 틀어지는데 테스트는 전부 통과합니다.
로그 한 줄에서 얻는 것은 평균이거나, 누군가 정한 기준을 넘은 요청의 건수입니다. 분기끼리 견주려면 분기마다 백분위가 있어야 하는데, 로그 수집 도구는 분기마다 따로 필드를 남겨야 그 값을 계산해 줍니다.
배포 직후의 요청은 평소보다 느립니다. 처음 몇 건은 규칙과 설정을 읽어 들이고 코드를 데우는 비용을 치르고, 그 뒤 몇 분도 평소 속도가 나지 않습니다. 이 기록을 평소 요청과 한 숫자로 섞으면, 배포 때마다 한 번 생기는 비용이 「가끔 아주 느린 요청」처럼 보여 p99를 끌어올립니다.
검사 전체의 합, 로그의 평균이나 건수, p99 가운데 어느 것도 가장 느려 보이는 분기를 고치면 전체 시간이 줄어드는지 알려 주지 않습니다.
패턴 정의
엔진은 규칙을 평가하면서 규칙마다 시간을 잽니다. 조건과 액션을 따로 재고, 같은 구간의 그룹 전체 시간 옆에 규칙별 백분위를 함께 내놓습니다. 다시 짤지 정하는 데 필요한 두 값이 조회 한 번에 다 나오는 셈입니다.
규칙별 시간은 요청 100건에 1건꼴로만 잽니다. 그래서 이 패턴은 규칙이 셋 이상이고, 구간 안에 요청이 1만 건쯤 있어 규칙마다 표본이 100건 쌓이는 그룹에 맞습니다. p99는 규칙마다 표본이 300건 쌓여야 나오므로 요청이 3만 건보다 넉넉히 쌓이기 전에는 답하지 못하고, 규칙이 512ns보다 작게 빨라진 것도 보이지 않습니다.
이 쿼터 검사에서 엔진이 다루는 것은 셋입니다. 요청마다 받는 fact, 그룹에 든 규칙, 규칙 하나의 시간을 나누는 단계입니다.
- fact: 요금제
tenantPlan, 이번 달 누적 호출 수apiCallsThisMonth, 요청에 달린 태그 목록userTags - 규칙: 알려진 요금제 셋을 하나씩 막는 규칙, 그 밖의 요금제를 막는 규칙, 한도에 다가선 free 요금제 고객사를 표시하는 규칙, 고객군 라우팅 규칙
- 단계: 조건(
CONDITION)은 조건 트리를 평가하는 데 쓴 시간이고, 액션(ACTION)은 걸린 규칙의 액션을 실행하는 데 쓴 시간입니다
요금제 차단 규칙 넷은 요금제로 요청을 나누므로, 한 요청에 많아야 하나만 걸립니다. 한도 근접 표시 규칙과 라우팅 규칙은 저마다 다른 fact(quotaWarning, segmentRoute)에 씁니다. 걸린 규칙끼리 부딪칠 일이 없으니, 걸린 규칙 가운데 하나만 남기는 상호 배타 그룹(Mutex Group)은 두지 않습니다. 두 규칙을 저장하기 전에 quotaWarning과 segmentRoute를 fact로 등록해 둡니다. 등록하지 않은 키에 값을 쓰는 규칙은 저장할 때 ACT-032로 거절됩니다.
{
  "name": "Block: free plan over monthly quota",
  "condition": {
    "type": "GROUP",
    "operator": "AND",
    "children": [
      {
        "type": "SINGLE",
        "field": "tenantPlan",
        "operator": "EQUALS",
        "value": "free",
        "valueType": "STRING"
      },
      {
        "type": "SINGLE",
        "field": "apiCallsThisMonth",
        "operator": "GREATER_THAN",
        "value": 10000,
        "valueType": "NUMBER"
      }
    ]
  },
  "actions": [
    {
      "type": "BLOCK",
      "parameters": {
        "reason": "apiCallsThisMonth exceeds the free plan quota 10000"
      }
    }
  ],
  "isEnabled": true
}
이 그룹에서 덩치가 커진 것은 고객군 라우팅 규칙(Segment routing)입니다. 조건은 묶음 여덟 개를 OR로 이은 모양이라, 그중 하나만 충족해도 규칙이 걸립니다. 묶음마다 먼저 요청의 userTags에 정해 둔 태그가 있는지 훑고, 이어서 apiCallsThisMonth와 tenantPlan을 기준과 비교합니다. 이 셋은 AND로 이어져 있어서, 셋 다 맞아야 그 묶음이 충족됩니다.
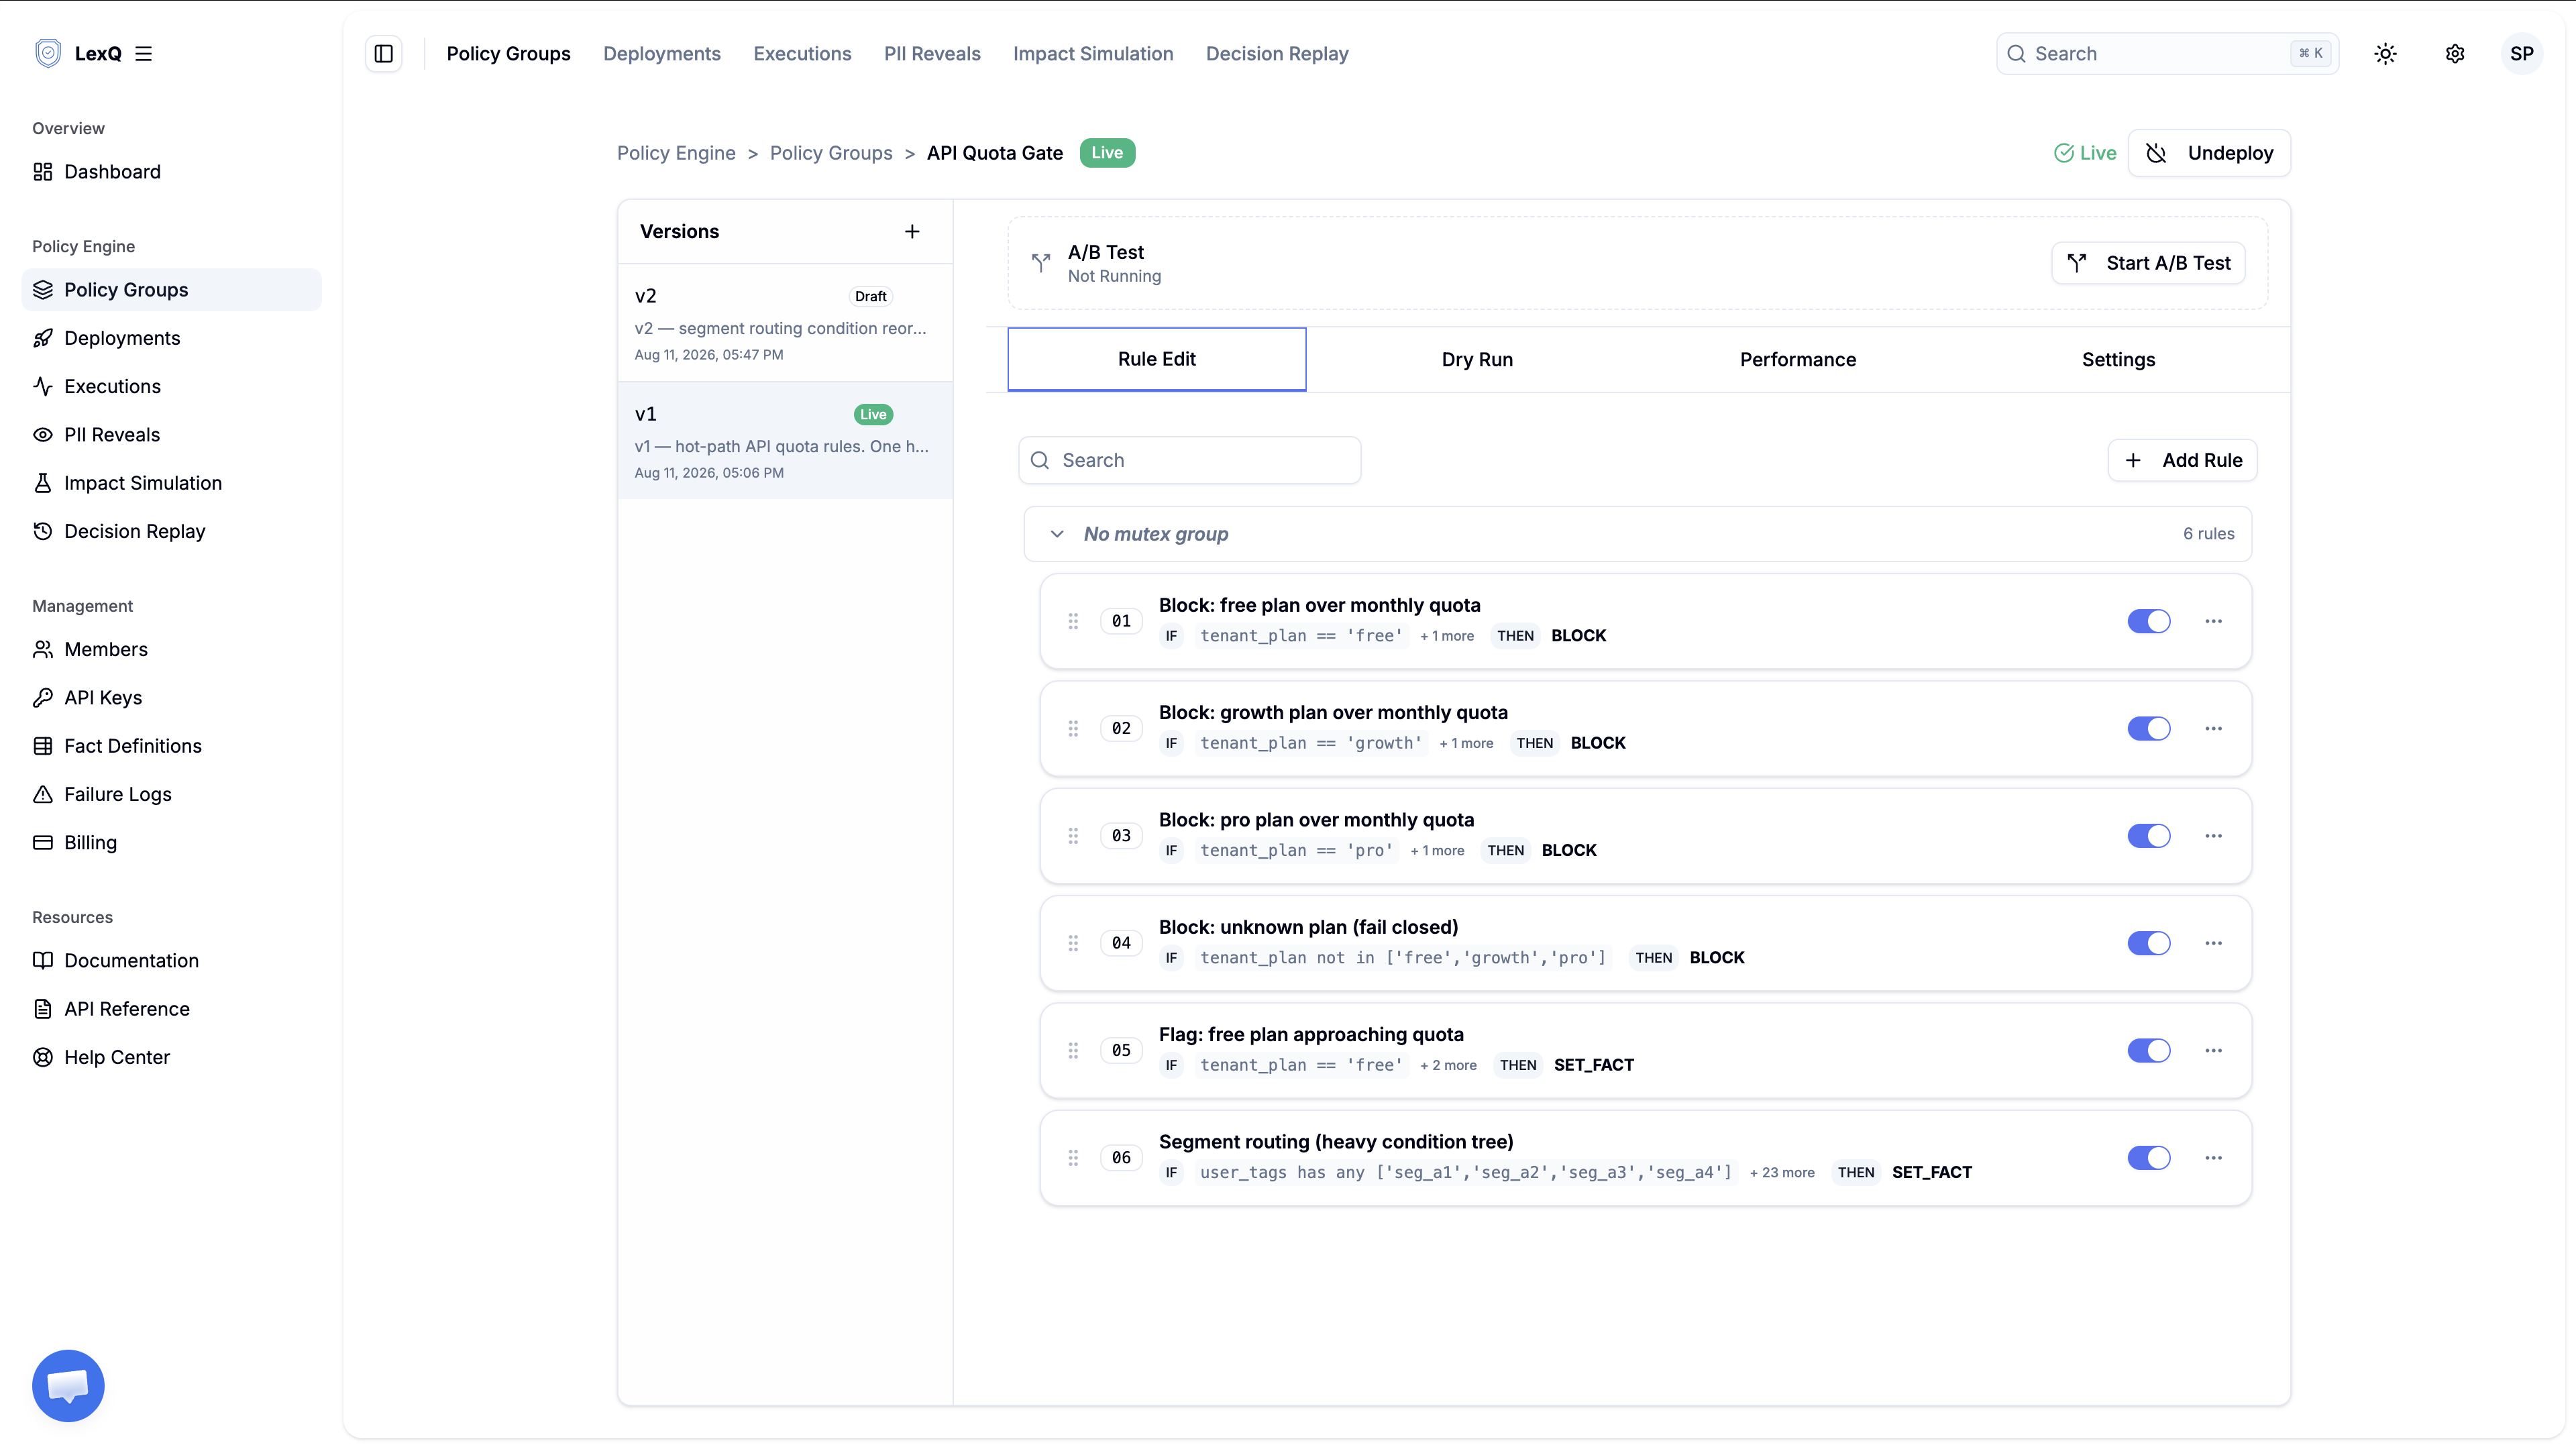
엔진은 규칙의 p50이 같은 그룹 규칙별 p50 중앙값의 10배에 이르면 「느림」 표시를 붙이고, 「5ms를 넘으면 느리다」 같은 고정 기준은 두지 않습니다. 같은 규칙도 서버가 바뀌거나 규칙과 트래픽이 달라지면 걸리는 시간이 달라집니다. 고정 기준을 문서에 적어 두면 그런 변화가 생긴 뒤에도 숫자는 그대로 남아, 이미 맞지 않는 기준으로 느린지를 판단하게 됩니다.
「느림」 표시와 기준 대비 배수가 알려 주는 것은, 그 규칙이 같은 그룹의 다른 규칙들보다 얼마나 느린지입니다. 다시 짤지 정하려면 그 규칙이 그룹 전체 시간에서 얼마를 쓰는지도 알아야 합니다. 프로파일에는 둘 다 있습니다. 규칙마다 기준 대비 배수가 있고, 그룹에는 규칙이 이미 컴파일돼 있던 호출(HIT)의 p50이 있습니다.
변경 영향 시뮬레이션 전략
라우팅 규칙의 몫이 3% 남짓이라 쿼터 검사 전체 시간은 거의 달라지지 않습니다. 이번에는 수정이 라우팅 규칙 자신의 조건 시간을 줄이는지를 봅니다. 대상 버전 v2는 운영 중인 v1을 복제해, 여덟 묶음 모두에서 검사 순서를 뒤집은 것입니다. 값싼 두 비교가 태그 확인보다 먼저 실행되고, 앞의 비교가 틀리면 지연 시간이 긴 태그 확인을 건너뜁니다. 셋이 모두 맞아야 한다는 조건은 순서를 바꿔도 같으니 결정은 하나도 바뀌지 않아야 하고, 내보내기 전에 시뮬레이션으로 그것부터 확인합니다.
데이터는 10월 1일에 쌓인 실행 이력입니다. v2를 여기에 돌리고, v1을 비교 기준으로 둡니다.
lexq analytics simulation start --json '{
  "policyVersionId": "<candidate-version-id>",
  "dataset": {
    "type": "HISTORICAL",
    "source": "EXECUTION_LOGS",
    "from": "2026-10-01",
    "to": "2026-10-01"
  },
  "options": {
    "baselinePolicyVersionId": "<baseline-version-id>",
    "includeRuleStats": true,
    "maxRecords": 50000
  }
}'
레코드 30,020건을 오류 없이 돌렸고, 두 버전 모두 29,200건이 규칙에 걸렸으며, 결정이 바뀐 레코드는 0건입니다.
규칙별 통계에는 대상 버전의 건수만 나옵니다. 그래서 같은 데이터셋을 v1만으로 한 번 더 돌립니다. 두 번 모두 여섯 규칙의 건수가 같습니다. 라우팅 규칙 29,054건부터 pro 요금제 차단 371건까지입니다. 같은 비교로 변경의 크기를 재는 방법은 변경 영향 시뮬레이션으로 배포 전 규칙 변경 테스트하기에 있습니다.
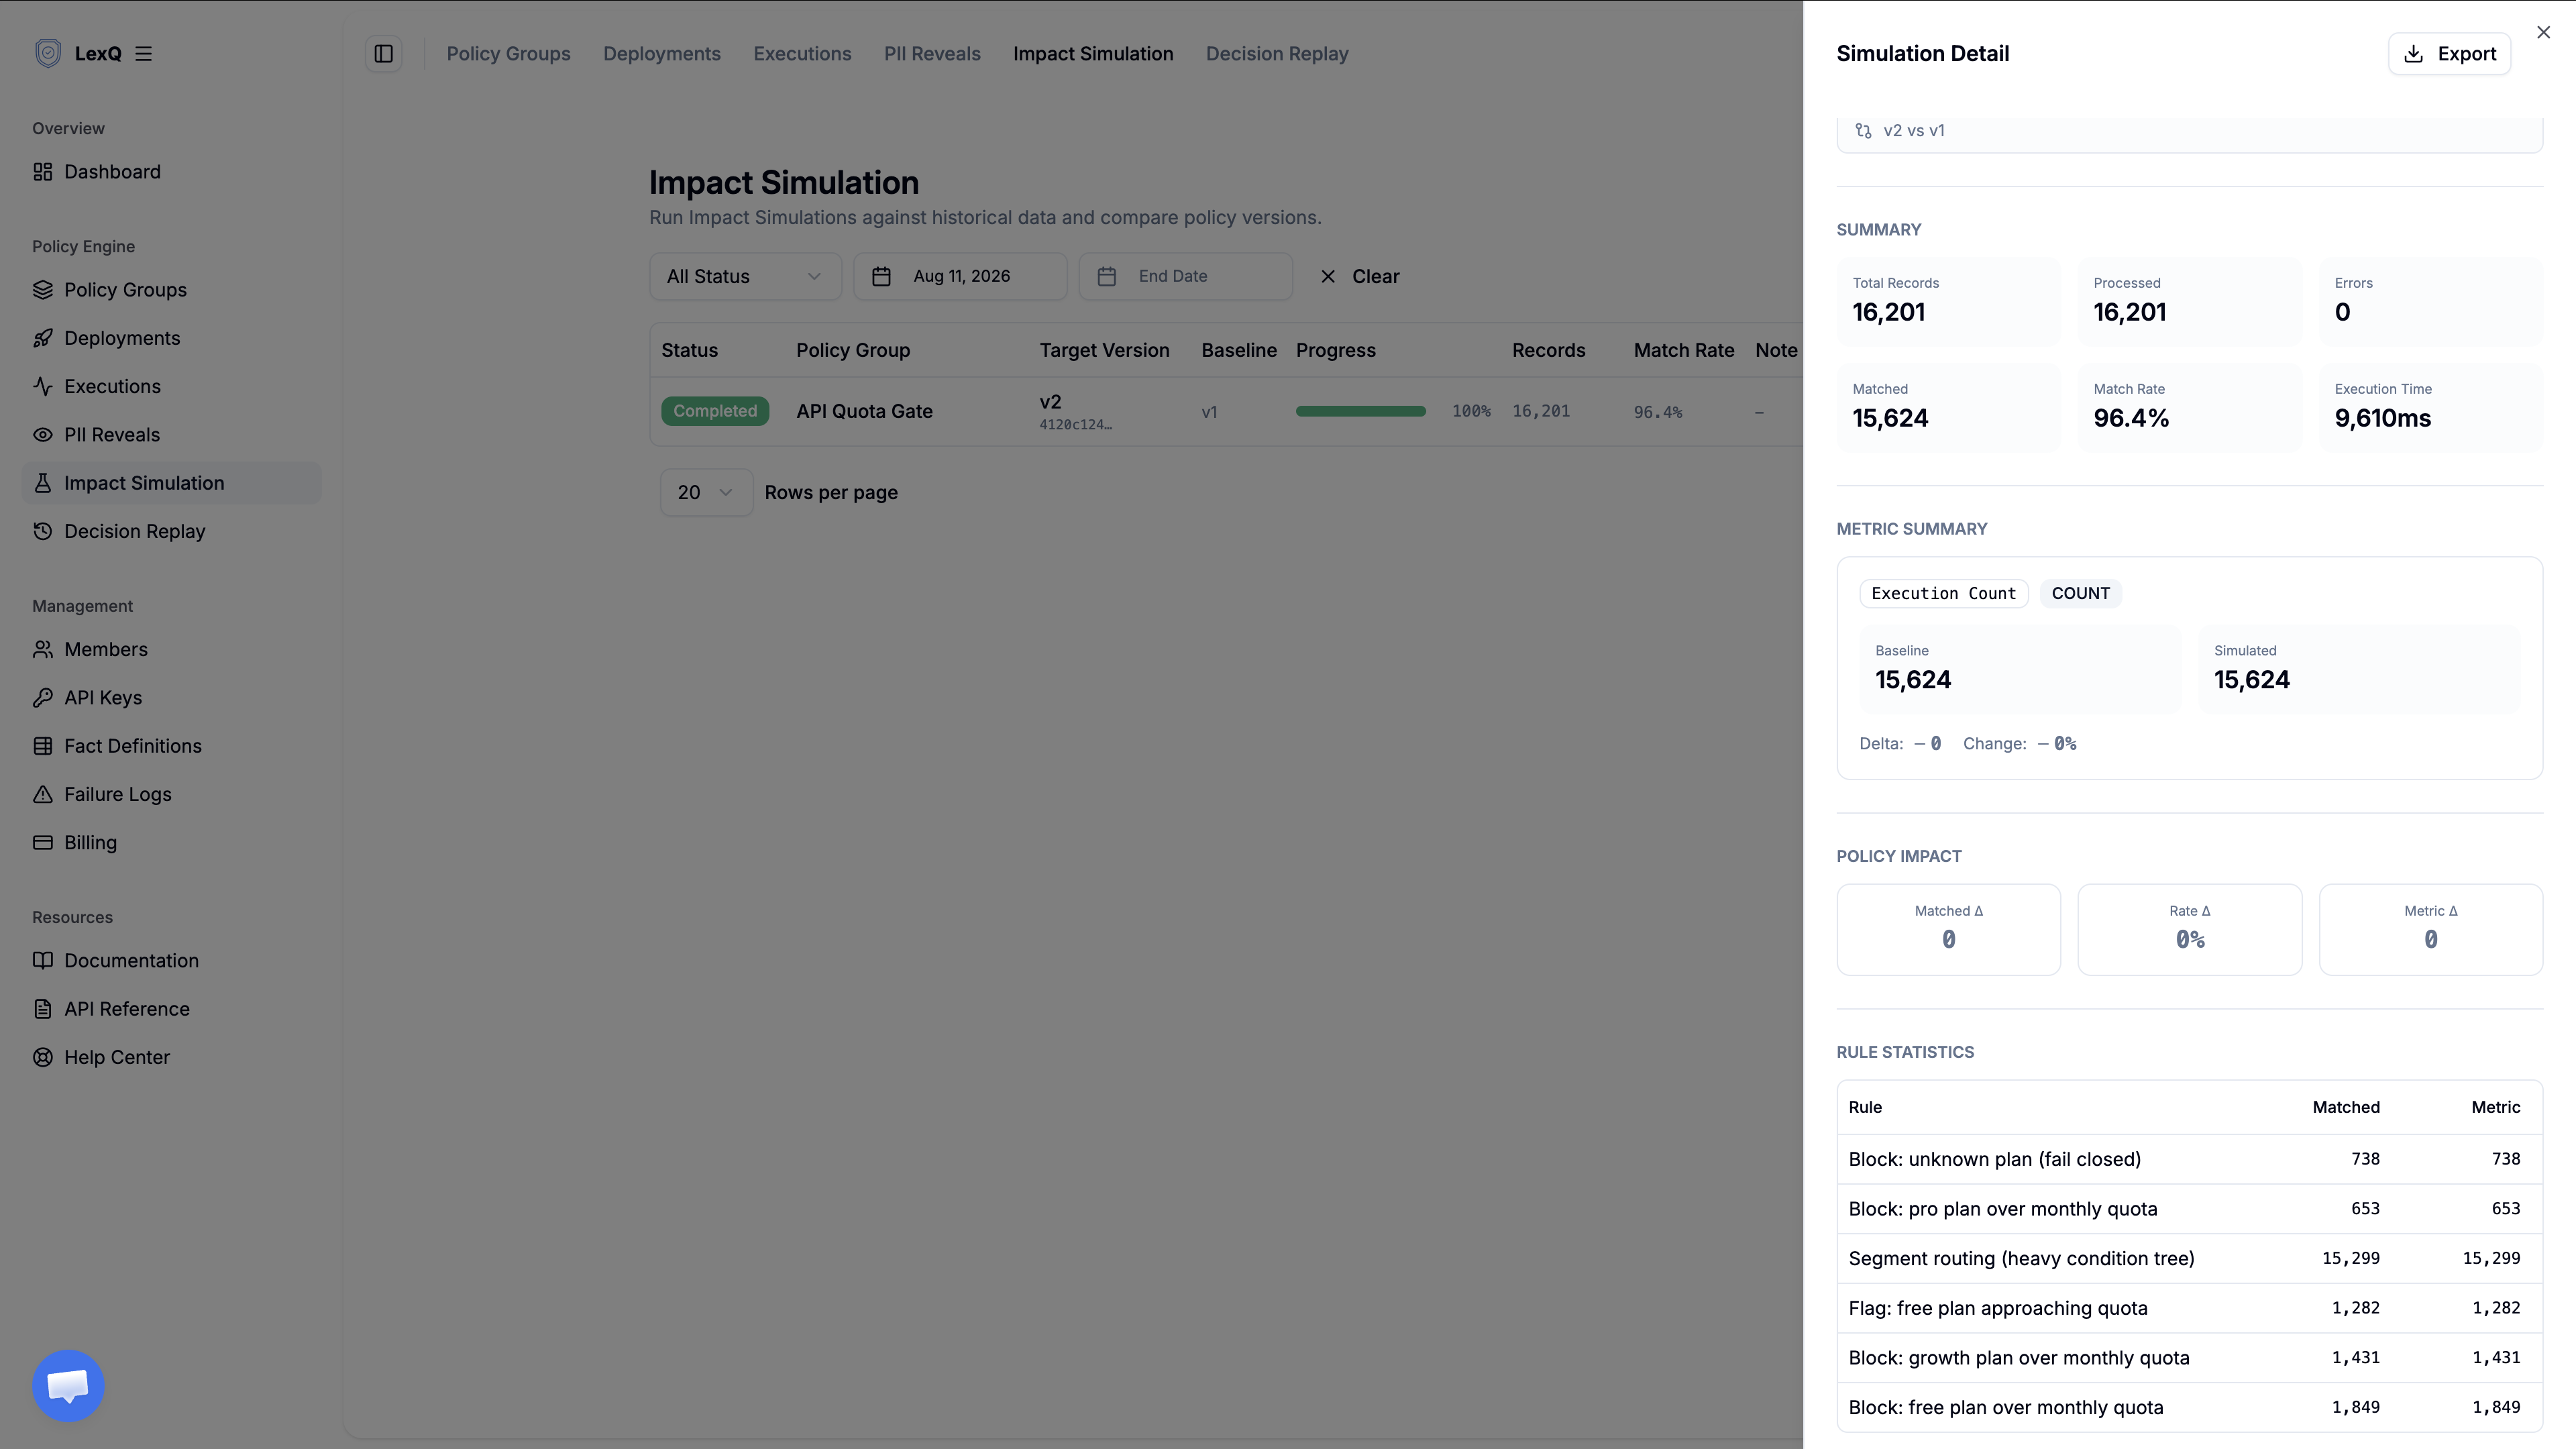
시뮬레이션은 지연 시간을 재지 않고, 결과가 어떻게 바뀌는지만 알려 줍니다. 지연은 운영 트래픽에서 읽어야 합니다.
의사결정 트레이스 출력
요청마다 의사결정 트레이스가 담긴 실행 이력이 남습니다. 거기서 쿼터 규칙은 저마다 미매칭(NO_MATCH)이나 선택됨(SELECTED) 가운데 하나를 받고, 막힌 요청의 generatedVariables에는 isBlocked와 blockReason이 생깁니다. 프로파일은 같은 요청들에서 나오는 두 번째 출력이고, 아래는 운영 버전에 요청 30,000건을 5분씩 두 번, 그 사이에 2분을 쉬고 보낸 결과입니다.
{
  "policyGroupId": "<group-id>",
  "policyVersionId": "<live-version-id>",
  "from": "2026-10-01T01:50:00Z",
  "to": "2026-10-01T02:09:00Z",
  "ruleCacheState": "HIT",
  "droppedRows": 0,
  "summary": [
    {
      "cacheState": "HIT",
      "total": { "n": 29995, "minNanos": 34816, "maxNanos": 42467327,
                 "p50Nanos": 811007, "p95Nanos": 1335295, "p99Nanos": 2768895 }
    },
    {
      "cacheState": "MISS",
      "total": { "n": 5, "minNanos": 16711680, "maxNanos": 43778047,
                 "p50Nanos": null, "p95Nanos": null, "p99Nanos": null }
    }
  ],
  "baselines": [
    { "phase": "CONDITION", "baselineP50Nanos": 1535,
      "cohortSize": 6, "status": "OK" },
    { "phase": "ACTION", "baselineP50Nanos": null,
      "cohortSize": 1, "status": "INSUFFICIENT_COHORT" }
  ],
  "rules": [
    {
      "ruleId": "<segment-router>",
      "phases": [
        { "phase": "CONDITION",
          "stats": { "n": 287, "minNanos": 1536, "maxNanos": 69119,
                     "p50Nanos": 3583, "p95Nanos": 9215, "p99Nanos": null },
          "baselineMultiple": 2.334201954397394, "flagged": false },
        { "phase": "ACTION",
          "stats": { "n": 274, "minNanos": 2560, "maxNanos": 163839,
                     "p50Nanos": 23039, "p95Nanos": 68095, "p99Nanos": null },
          "baselineMultiple": null, "flagged": false }
      ]
    },
    {
      "ruleId": "<free-plan-block>",
      "phases": [
        { "phase": "CONDITION",
          "stats": { "n": 287, "minNanos": 1536, "maxNanos": 411647,
                     "p50Nanos": 4607, "p95Nanos": 25599, "p99Nanos": null },
          "baselineMultiple": 3.0013029315960913, "flagged": false },
        { "phase": "ACTION",
          "stats": { "n": 10, "minNanos": 32768, "maxNanos": 156671,
                     "p50Nanos": 42495, "p95Nanos": null, "p99Nanos": null },
          "baselineMultiple": null, "flagged": false }
      ]
    }
  ]
}
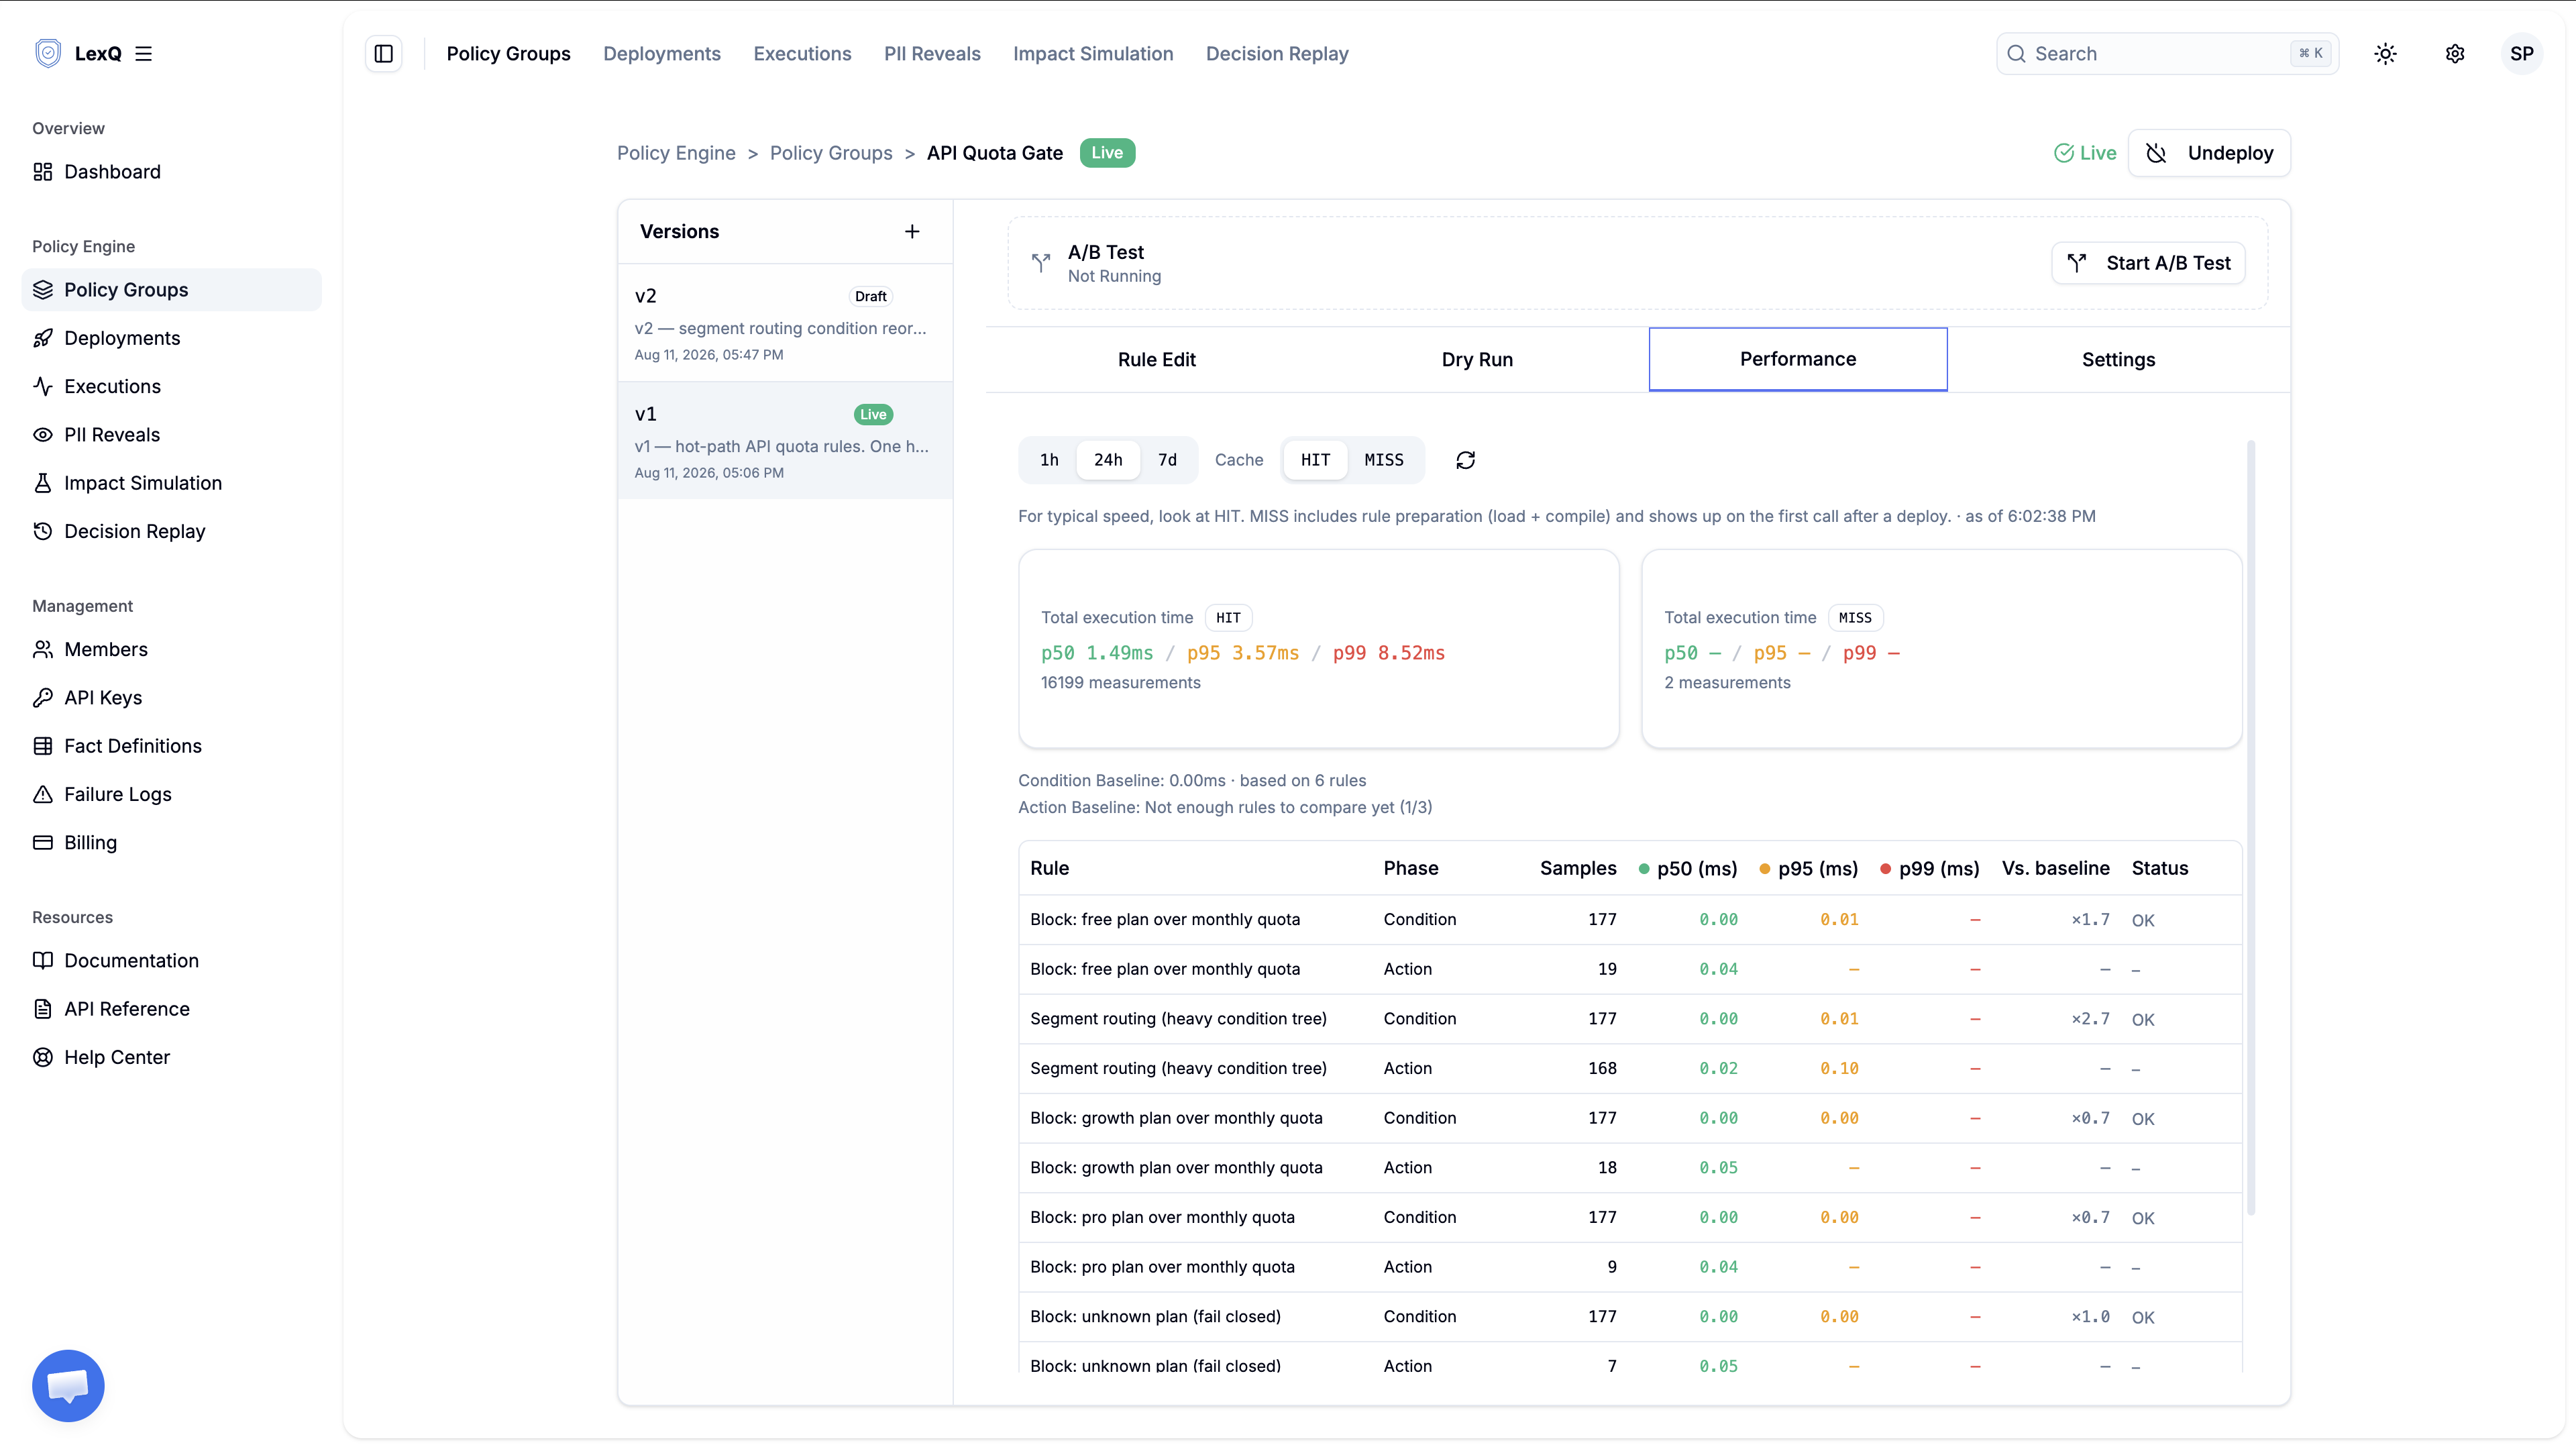
summary는 그룹 전체 값으로, 호출마다 기록되고 캐시 상태로 갈립니다. baselines에는 배수의 분모인 규칙별 p50의 중앙값이 들어 있습니다. droppedRows는 저장된 구간 가운데 읽지 못한 것의 수로, 여기서는 0입니다. 규칙마다 백분위 옆에 측정 수 n이 붙고, 위 응답에는 여섯 규칙 중 둘만 남겼습니다.
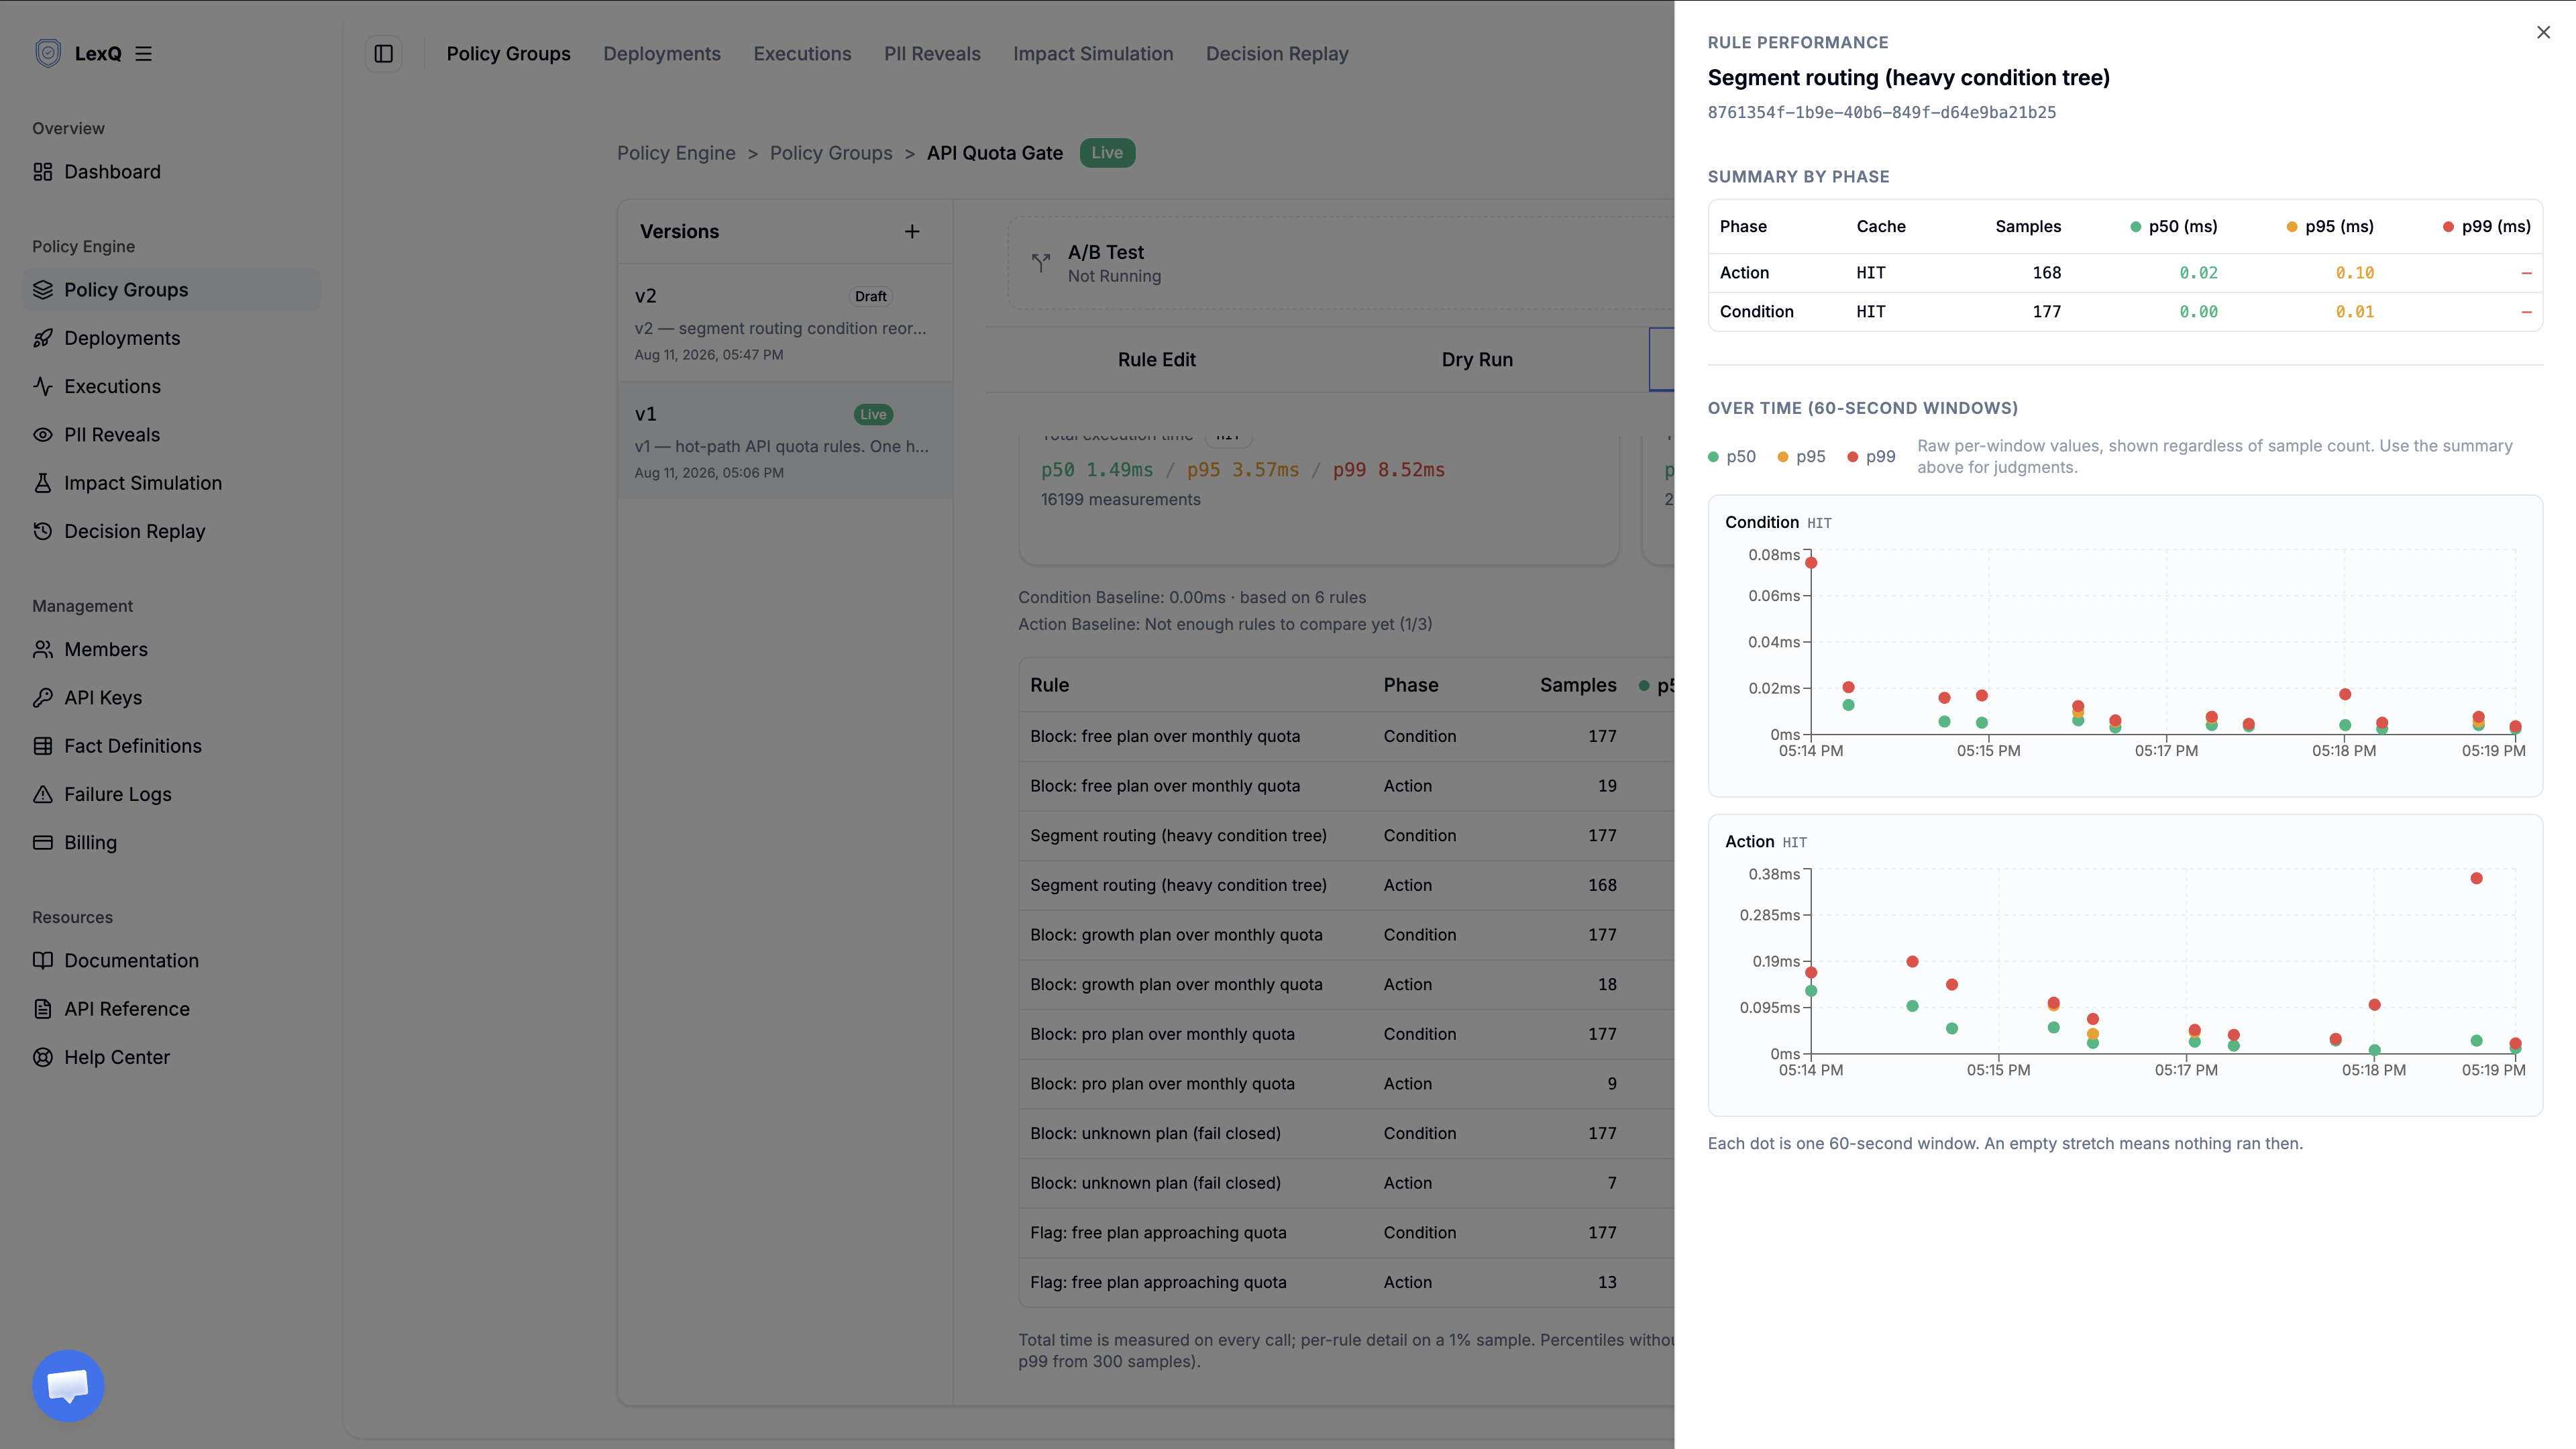
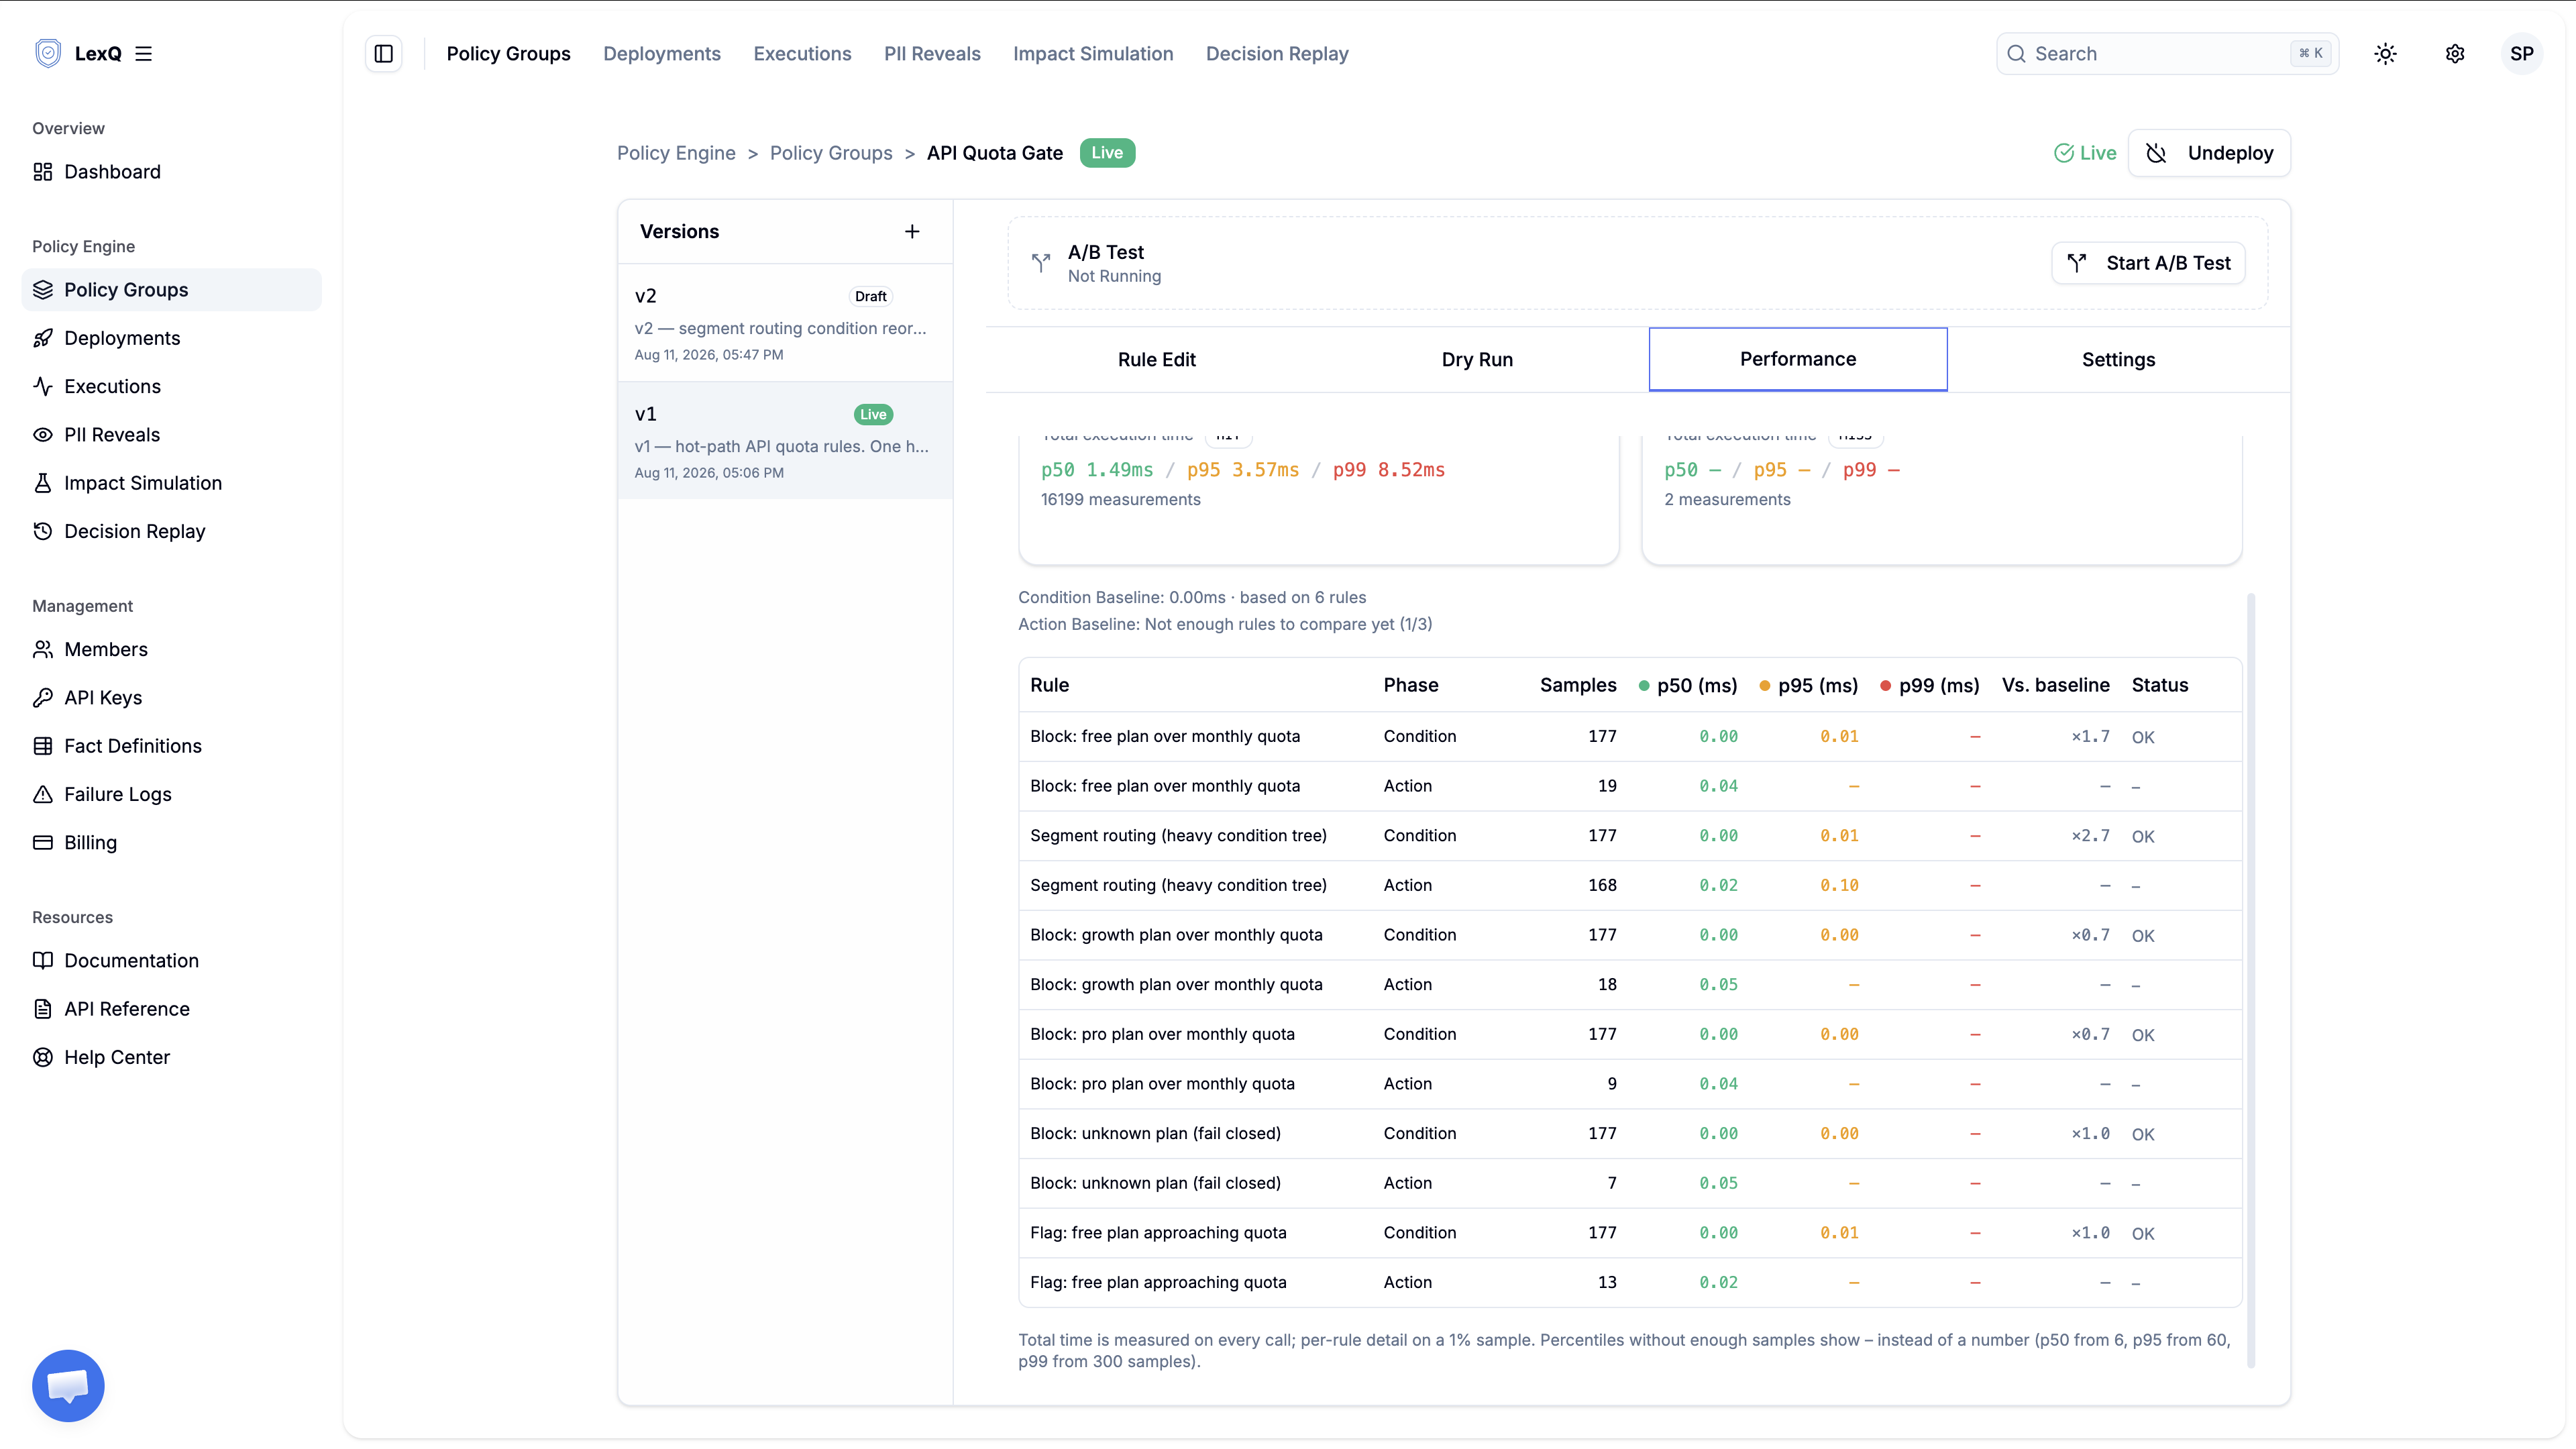
배수 순위는 free 요금제 차단 규칙이 3.00으로 1위, 라우팅 규칙이 2.33으로 2위이고, 「느림」 표시가 붙은 규칙은 없습니다. free 요금제 차단 규칙이 앞선 것은 측정 첫 4분 때문입니다. 이 규칙의 60초 구간별 p50은 처음 4분 동안 7,67927,135ns이고, 그 뒤로는 3,0714,095ns입니다.
라우팅 규칙의 몫은 조건과 액션을 더해 셉니다. 조건 p50이 3,583ns, 액션 p50이 23,039ns이고, 표본 요청 287건 중 274건에서 액션이 실행됩니다. 요청 하나에 약 26µs로, 그룹 HIT p50 811,007ns(약 811µs)의 3% 남짓입니다. 규칙 하나를 다시 짜서 그룹 p50을 줄일 수 있는 폭은 그 규칙의 몫까지입니다. 여섯 규칙을 다 더해도 약 5%라서, 이 쿼터 검사가 쓰는 시간은 대부분 규칙 평가 밖에 있습니다. 규칙 밖의 시간은 엔진이 들어온 fact를 확인하고, 걸린 규칙 가운데 무엇을 적용할지 정리하고, 실행 이력을 만드는 데 씁니다. 프로파일은 이 시간을 더 나눠 보여 주지 않습니다.
엣지 케이스
그룹 전체 시간(summary)은 요청마다 기록하지만, 규칙별 시간은 정해진 방식으로 고른 요청 100건에 1건꼴로만 기록합니다. 이번 요청 30,000건에서는 규칙마다 이런 표본이 287건 쌓였습니다. 표본이 모자라면 백분위는 값 대신 null로 나오는데, p50은 표본 6건, p95는 60건, p99는 300건부터 나옵니다(n × (1 − q) ≥ 3). 그래서 라우팅 규칙의 p99는 표본 287건일 때 null이었고, 307건이 쌓인 다음 측정에서야 나왔습니다. 이 글의 「라우팅 규칙 몫 3%」는 보통 요청(p50)을 기준으로 잰 값입니다. 쿼터 검사의 문제는 가장 느린 1% 요청(p99)이 느려진 것이지만, 규칙별 p99가 비어 있어 그 기준으로는 잴 수 없었습니다. 규칙끼리 배수를 견주려면 표본이 100건을 넘는 규칙이 셋 이상 있어야 합니다. 그보다 적으면 baselines에 INSUFFICIENT_COHORT(콘솔에서는 「비교할 규칙이 아직 부족합니다」)가 찍히고, 배수를 계산하지 않습니다.
액션은 규칙이 걸렸을 때만 돌기 때문에 규칙마다 표본 수가 고르지 않습니다. 이 그룹에서 표본이 100건을 넘는 액션은 라우팅 규칙 하나뿐이라, 액션 기준선은 INSUFFICIENT_COHORT이고 어느 액션에도 배수가 붙지 않습니다. 그런데 라우팅 규칙이 시간을 더 많이 쓰는 쪽은 액션이고, 조건의 약 6배입니다. 그래도 이 글에서 조건을 고친 것은, 액션이 이 규칙이 내는 결과 그 자체라 고치면 규칙의 결정이 바뀌기 때문입니다. 액션의 p50은 그룹 전체 값과 바로 견줍니다.
MISS는 따로 보는 집단입니다. 버전을 읽어 들이고 컴파일하는 호출이고, 여기서는 5건이 16.7~43.8ms 걸렸습니다. 첫 몇 분이 느린 것은 이와 다른 현상이라 HIT 안에 그대로 섞입니다. 배포 시각부터 잡은 구간에는 그 몇 분이 들어가 순위가 뒤바뀔 수 있습니다. 시계열에서 값이 가라앉는 지점을 찾고, 비교는 그 뒤 구간끼리 합니다.
배수는 같은 그룹의 다른 규칙들이 움직이면 같이 움직입니다. 순서를 바꾼 뒤 라우팅 규칙의 조건 p50은 3,583ns 그대로인데, 중앙값이 1,535ns에서 1,023ns로 내려가는 바람에 배수는 2.33에서 3.50으로 오릅니다. 프로파일은 약 131µs 아래의 시간을 512ns 단위로 끊어 세고, 백분위는 그 칸의 윗값으로 보여 줍니다. 그래서 3,583ns는 3,072~3,583ns 사이라는 뜻이고, 중앙값은 한 칸 내려갔을 뿐입니다. 변경의 효과는 같은 길이의 구간에서 그 규칙 자신의 p50으로 판단하고, 배수는 순위를 매기는 데만 씁니다.
시계열은 다듬지 않습니다. 점 하나가 엔진 프로세스 하나의 60초 구간이고, 표와 달리 표본이 적어도 값을 비우지 않습니다. 표본 호출이 한 건뿐인 구간에서는 그 한 건이 p50이자 p95이자 p99입니다. 대신 표본이 하나도 없는 구간에는 점을 찍지 않습니다. 측정 중간에 요청을 2분 동안 보내지 않았기 때문에, 위 이미지의 위쪽 그래프 가운데쯤에 점이 없는 빈 곳이 있습니다.
운영 배포
결정이 바뀌지 않으니 v1 자리에 v2를 한 번에 올리고, 배포 메모에는 바꾸기 전의 프로파일과 예상하는 결과, 되돌릴 조건을 적습니다.
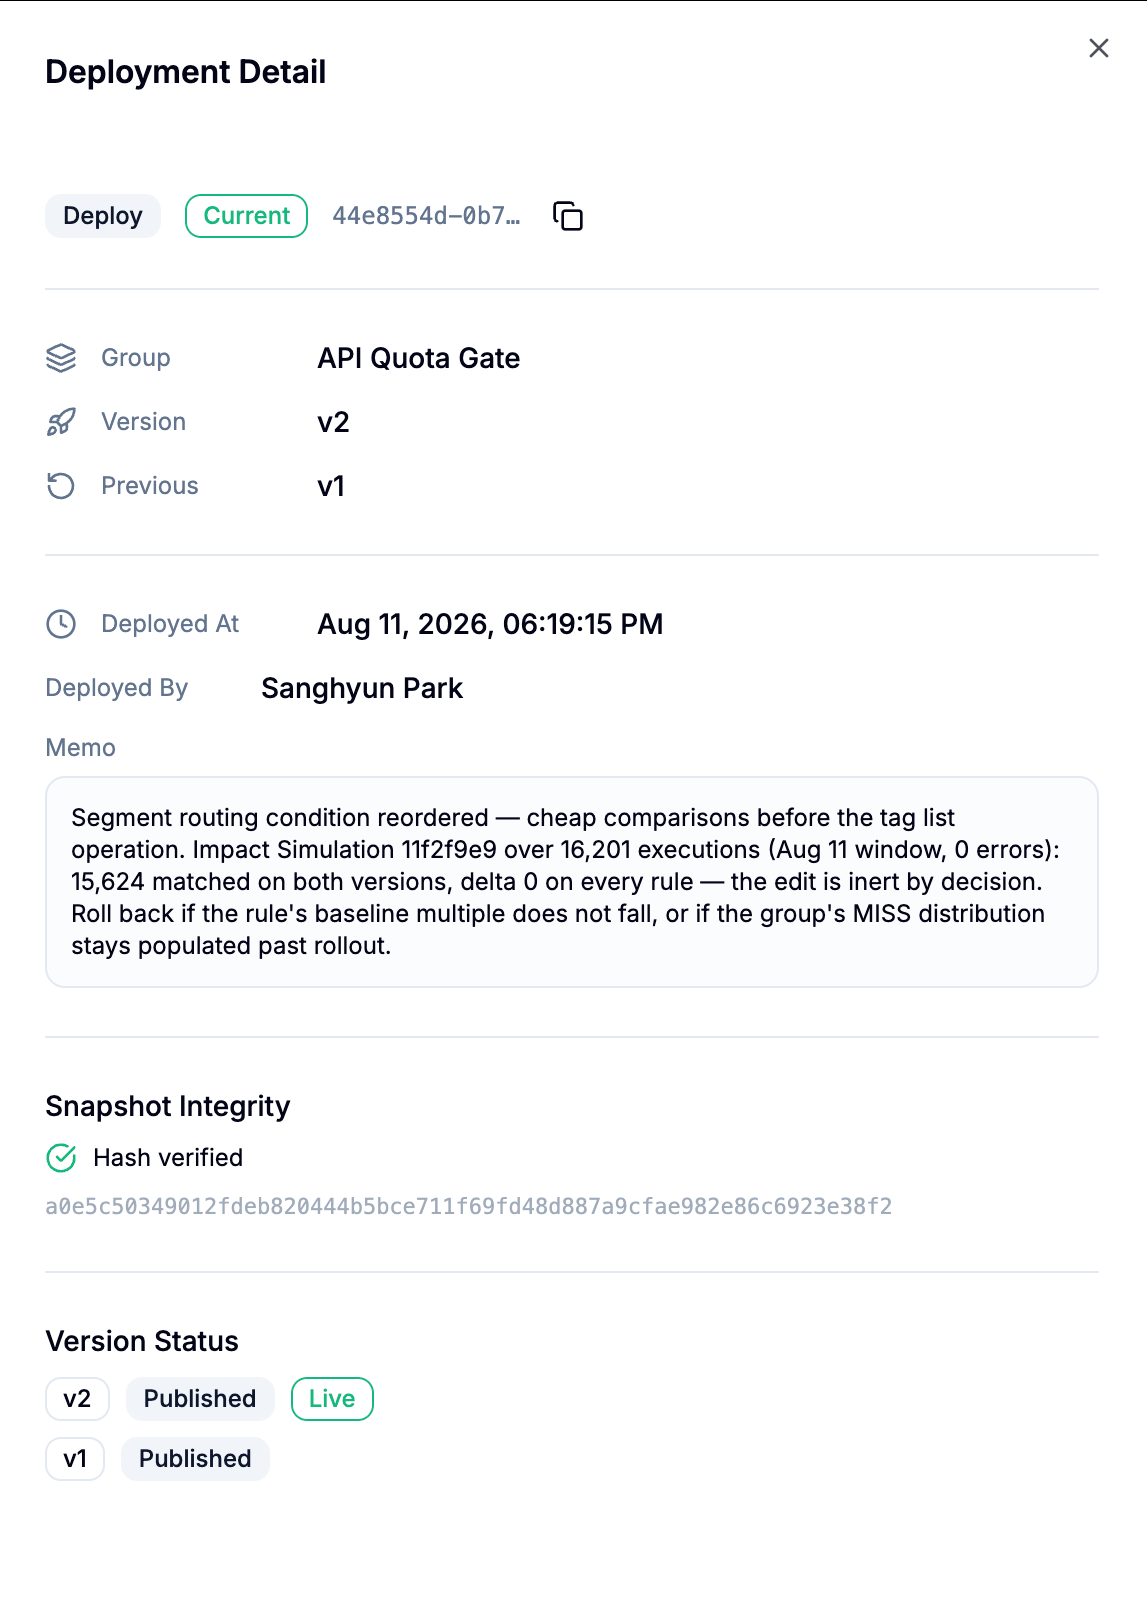
배포한 뒤 같은 요청 30,000건을 같은 순서, 같은 쉬는 시간으로 다시 보냅니다. 라우팅 규칙의 조건 p50은 3,583ns 그대로입니다. 측정마다 마지막 5분의 그룹 HIT p50은 바꾸기 전 720,895ns, 바꾼 뒤 737,279ns입니다. 앞으로 옮긴 두 비교는 거의 모든 요청에서 맞기 때문에, 태그 확인을 건너뛰는 묶음이 거의 없습니다.
01:54        v1 운영 시작
01:54~02:06  요청 30,000건 (5분, 2분 쉼, 5분)
02:10        변경 영향 시뮬레이션: 30,020건 중 바뀐 건 0
02:15        v2 운영 시작, 메모에 예상 결과와 되돌릴 조건
02:16~02:28  같은 요청 30,000건
02:34        v1 다시 운영, 라우팅 규칙의 조건 p50 그대로
다시 짠 규칙 자신의 p50이 내려가지 않으면 롤백합니다. 첫 몇 분을 뺀, 같은 길이의 구간끼리 견줍니다. 배포가 한참 지났는데도 그룹의 MISS 건수가 계속 늘어도 롤백합니다. 엔진이 배포 횟수보다 자주 버전을 다시 읽어 들이고 있다는 신호이고, 그러면 프로파일에 잡히는 시간은 대부분 컴파일입니다.
이번 측정에서는 라우팅 규칙의 조건 p50이 내려가지 않았으므로 롤백하고, v1을 다시 운영에 올립니다. 이미지의 배포 메모는 이 롤백 조건을 배수로 적었습니다(「2.33에서 내려가지 않으면 롤백」). 이 기준으로도 롤백이지만, 배수가 오른 것은 중앙값이 내려간 탓입니다. 그 규칙 자신의 p50으로 조건을 적으면, 다른 규칙이 움직여도 판단이 흔들리지 않습니다.
LexQ가 어떻게 동작하는지 playground에서 직접 확인해보세요.